2023 年,我開始使用 Gemini,後來成為長期年費用戶,也一直保留著 Notion AI。到了 2026 年,Codex 和 ChatGPT 逐漸進入我的日常開發;在常用接入渠道受限時,我也會切換到 Claude Code。
這些工具陪我處理過不同類型的工作:寫代碼、討論系統設計,以及嘗試通過 Agent 幫創始人打造企業家 IP、準備口播稿。
用得越久,我越在意一個變化:原來有些想法會停在“這個我會不會做”,現在更容易先邁出一步,去討論它應該怎樣做、值得做到什麼程度。
一、從持續使用,到按任務選擇工具
持續訂閱讓我有機會把 AI 放進日常工作,觀察它在反覆修改和不同任務中的表現。一次回答驚豔,並不足以決定一個工具能否長期留下來;我更關心它能不能陪我把事情繼續推進。
目前,我常用的模型包括 ChatGPT 環境中的 6 Sol、Claude Code 中的 5.5 Haiku,以及 Gemini 3.1 Pro。版本會繼續變化,下面記錄的是我的使用感受和選擇邏輯。
| 工具 | 在我的工作中的位置 |
|---|---|
| ChatGPT 與 Codex | 當前最常用的組合,覆蓋代碼實現、問題討論和系統設計。GPT 給我的整體感受最全能。 |
| Claude Code | 另一條開發協作路徑,常用接入渠道受限時,可以繼續推進編碼工作。 |
| Gemini | 從 2023 年開始持續使用。在口播等內容表達任務中,我通常更喜歡它的文字風格。 |
| Notion AI | 長期保留的工具之一,與開發工具一起構成我的日常 AI 工具組合。 |
這些選擇來自個人任務與偏好,沒有經過控制變量的模型評測。尤其是“文案更有人味”,包含了我對語氣和表達的主觀判斷,也受到輸入材料與修改要求的影響。
一個月的實際調用記錄
下面是我在 2026 年 9 月使用其中一個 AI 接入平臺的統計截圖:當月共有 45,118 次請求,平臺統計的總 Token 約為 49.5 億,顯示的實際消費約為 674.23 美元。它記錄了 AI 已經進入我日常工作、被持續調用的一段經歷。
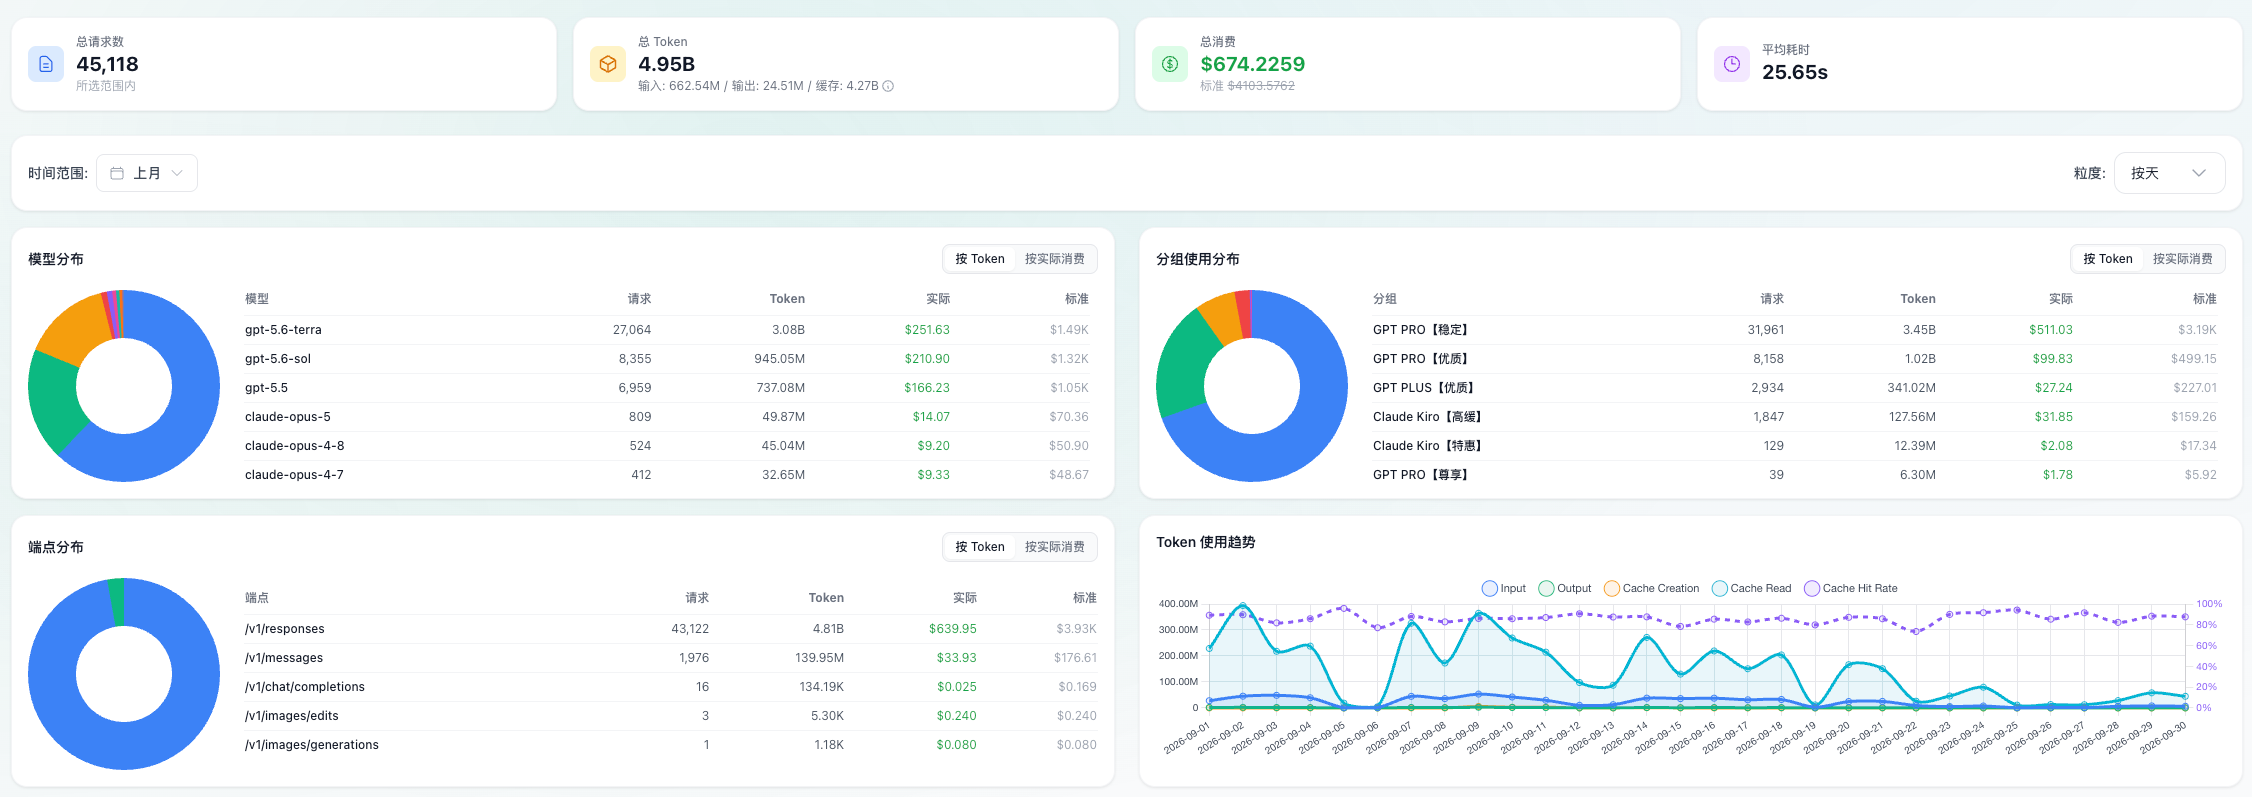
這裡的總 Token 包含約 42.7 億緩存 Token,不能全部理解為新生成的內容;消費金額也以該平臺的計費口徑為準。這張圖只覆蓋該接入平臺,不代表我在所有 AI 工具上的完整用量。
調用量讓我能在大量實際任務中反覆觀察工具,但工作是否有效,最終還是要看代碼能否通過驗證、方案能否落地,以及內容能否被採用。
二、GPT 讓我把更多注意力放到架構上
過去面對一個功能,我經常先判斷自己是否熟悉對應技術、有沒有足夠時間把它寫出來。實現成本會提前限制想法的範圍。
引入 Codex 和 ChatGPT 後,實現變得更容易啟動了。陌生的框架、以前沒有寫過的交互,或者需要跨多個模塊修改的需求,都可以先拆開,再逐步推進。
那種感受很直接:好像沒有什麼功能不能嘗試,甚至會有一點“世界盡在掌握”的興奮。
我把這種感受理解為嘗試邊界的擴大。功能能夠被寫出來之後,仍然有很多判斷需要完成:業務規則是否成立,模塊職責是否清楚,狀態應該放在哪裡,失敗後如何恢復,以及後續修改會影響哪些地方。
因此,我可以把更多精力放在架構和取捨上。代碼生成的速度越快,越需要有人明確本次要解決的問題、必須遵守的約束,以及可以接受的結果。
AI 讓我更敢去嘗試一個方案,也讓我更清楚,架構設計和結果驗收需要持續參與,不能只停留在最初的一次提問。
三、一次真實修復:與 AI 協作梳理 MQ 消費事務邊界
在 RegenBio 報告系統的一次排查中,我遇到了一個具體問題:報告審批通過 RocketMQ 異步流轉,消費邏輯拋出異常後,數據庫中的變更卻沒有按預期回滾。
這次需要處理的是消費端的本地數據庫事務,而不是 RocketMQ 事務消息機制本身。消息重試與數據庫回滾分別由不同的機制負責,異常能夠觸發重新投遞,並不代表之前的數據庫操作已經撤銷。
從故障現象追到調用鏈
我先讓 AI 閱讀消息模板和報告審批監聽器的代碼,分析可行方案。它沿調用鏈區分了兩個邊界:發送端已有事務提交後發消息的設計;消費端則由公共監聽器入口直接調用業務消費方法。
報告監聽器雖然聲明瞭 @Transactional,但繼承的入口和內部調用方式,使這段業務邏輯是否真正經過 Spring 事務代理成為排查重點。AI 據此提出在公共消費入口顯式管理事務,並指出失敗狀態寫入、異常重試和通知發送之間還有需要分別處理的問題。
這裡有價值的協作,是把“拋異常為什麼不回滾”拆成可以檢查的調用路徑、事務邊界和副作用,而不是看到事務註解就認定它一定生效。
我的取捨:先統一能力,控制業務改動
AI 最初提出了更完整的調整方向,包括拆分審批業務服務、整理失敗語義,以及調整通知發送時機。我沒有一次性推進所有重構,而是先確認:能否只在 core 層補齊 MQ 消費事務契約,再讓 Report 接入這項能力?
這樣選擇,是因為事務執行屬於多個消費者可以複用的基礎能力。先將它收斂到公共入口,可以減少各個業務監聽器對註解和代理調用方式的隱含依賴,同時控制這次故障修復涉及的業務範圍。
最終採用的方案是在公共監聽器中增加按需開啟事務的開關,由 TransactionTemplate 包裹業務消費方法。默認保持原有非事務行為,需要本地事務的監聽器顯式開啟;異常繼續交給 RocketMQ 處理重試。顯式要求事務卻缺少事務管理器時,則直接報錯,避免靜默退化為無事務執行。
Report 先切換為這套消費事務能力,保留原有審批業務結構。修復目標因此比較明確:先讓消費失敗時的本地數據庫回滾有一個統一、可測試的執行邊界。
從單點修復到同類檢查
完成第一處修改後,我繼續要求 AI 檢查其他監聽器,判斷哪些也需要事務。檢查範圍擴展到了授權、框架、基礎設施、報告等模塊中的消費實現。
這裡沒有把所有監聽器一律開啟事務。涉及本地數據庫狀態寫入的消費者接入統一能力;純緩存刷新和配置刷新不需要數據庫事務;郵件、短信、文件上傳等外部動作,也不會因為開啟本地事務就獲得回滾能力。
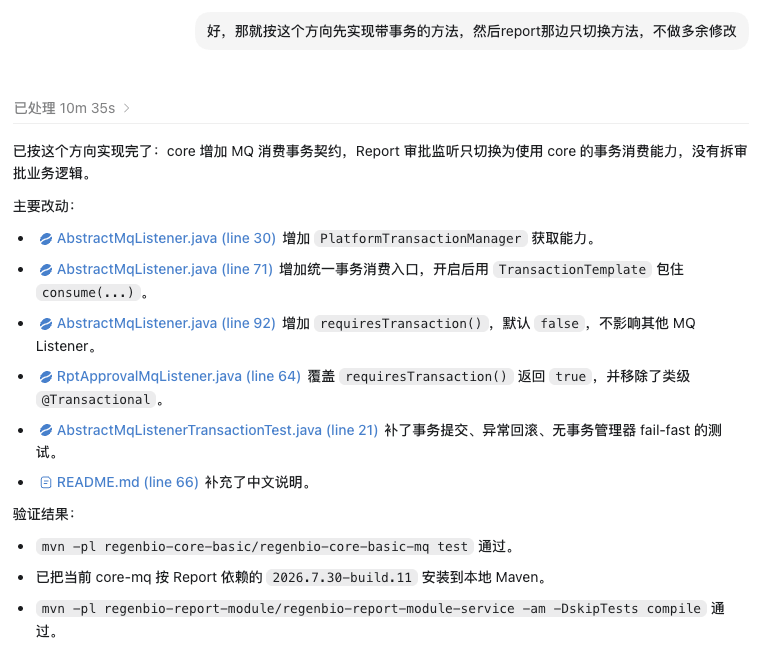
對話中的執行記錄顯示,公共組件補充了提交、異常回滾,以及缺少事務管理器時立即失敗的測試,組件測試通過;Report 和後續調整涉及的多個業務模塊也完成了編譯檢查。
驗證到哪裡,結論就寫到哪裡
這些記錄支持公共組件的事務執行測試與業務模塊編譯已通過,還需要在真實業務鏈路中驗證消費異常後的數據庫狀態、消息重投與通知行為,才能判斷業務效果。
本地事務也不會自動解決重複消費、重試耗盡、外部調用副作用,或數據庫提交與消息發送之間的故障窗口。審批失敗狀態應該回滾還是保留、通知應該何時發出,都需要按業務語義繼續設計。
這次協作中,AI 幫助閱讀跨模塊代碼、梳理候選方案並執行修改;我持續決定修復目標、公共能力的歸屬、變更範圍和驗收邊界。比起一次生成多少代碼,這更接近我希望展示的 AI 工程協作能力。
四、這個網站,也是一次持續的人機協作
這個個人網站就是一個具體例子。文章、項目案例、履歷、國際化和深色模式,是在連續討論與修改中逐步形成的。
其中很多要求,最初只有一個方向。例如,希望頁面更接近日系網站的氣質,希望項目介紹體現業務,希望文章閱讀結束後的推薦與返回操作更清楚。
這些要求需要在實際頁面中繼續明確:哪些內容先出現,哪裡應該保留留白,哪些分割線沒有必要,以及同一類按鈕是否真的對齊。
文章底部的調整尤其典型。先確定“相關案例”和“繼續閱讀”左右排列,再收斂為相同樣式的橫幅;隨後將欄目名移入橫幅,縮小內容標題、限制單行省略,最後修正分享與返回按鈕的水平對齊。
“左右排列”只解決了結構問題。視覺層級、文字密度和操作關係,還需要通過頁面效果繼續判斷。AI 可以幫助修改代碼,我仍然需要指出具體哪裡不成立,並在下一輪結果中確認它是否被解決。
這段過程讓我對協作的理解更具體:提出方向之後,還要能夠觀察結果,把不滿意的感受轉成可執行的修改要求。
五、做口播內容時,我更偏好 Gemini 的表達
開發之外,我也嘗試操作 Agent,協助創始人打造企業家 IP,口播稿是其中一類工作。
這類內容需要適合一個真實的人開口表達。觀點是否清楚,句子能不能自然說出來,語氣是否貼近本人,以及聽眾能否跟上,都影響稿件能不能使用。
在這類任務中,Gemini 給我的感受是文字更有人味,AI 味更淡。我通常更願意以它的表達作為繼續修改的起點。
但“讀起來順”還不足以決定稿件可以交付。創始人是否認同其中的判斷,材料能否支撐觀點,有沒有把推測寫成事實,仍然需要人工確認。尤其是個人經歷、企業成果和具體數據,不能為了讓故事完整而由模型補齊。
這也解釋了為什麼我會同時保留多個工具:開發與口播對結果的要求不同,我願意根據任務選擇更合適的協作方式,而不是要求一個模型在所有場景中都採用同一種表達。
六、我希望展示的是怎樣的 AI 能力
持續使用這些工具之後,我更看重三件事:能否把模糊的想法說清楚,能否讓工具在已有約束內推進,以及能否判斷結果是否達到要求。
在開發中,這些判斷落到業務邊界、架構設計和驗證上;在內容工作中,則落到受眾、事實和表達上。模型可以參與其中很多步驟,最終仍需要有人決定哪些結果可以留下。
個人工作中的 AI 協作,與把 AI 做成可持續運行的業務產品,也有不同的要求。LAIFE AI 項目案例記錄了健康資料、AI 助手與服務運營如何連接;《AI 時代的軟件工程:規格、約束與驗證》則進一步討論瞭如何檢查 AI 實現。
我願意繼續嘗試新的工具。AI 已經讓我更容易把一個念頭推進到可以看見、可以討論的階段;接下來,仍要把它打磨成真正適合使用的結果。